Jev는 텍스트를 읽고, 주어진 선택지에서 답을 고르거나 기준에 따라 점수를 매기는 모델이다. 질문과 답변 기준을 함께 보내면 결과를 확률과 함께 받는다. TypeSafe가 2026년 9월 15일 공개했으며, 회사는 이를 System One 모델이라고 부른다. Introducing System One Models & Jev
LLM으로 서비스를 만들 때는 글이나 코드를 생성하는 일 외에도 분류와 평가가 필요하다. 이런 작업은 긴 설명보다 선택한 항목이나 점수가 필요할 때가 많다. Jev는 그 결과를 코드에서 받아 쓸 수 있도록 설계됐다.
관심이 간 부분은 이런 작업을 범용 LLM 대신 맡길 수 있다는 점이었다. 필요한 품질을 유지하면서 비용과 대기 시간을 줄일 수 있다면, 에이전트 안에서 모델의 역할을 더 세밀하게 나눌 수 있을 것이다. 먼저 Jev의 입력과 출력부터 알아보고, 예제를 통해 어떻게 사용하는지 살펴보자.
State와 Questionh2
Jev에 요청을 보낼 때는 읽을 내용과, 그 내용에서 알아낼 것을 나눈다. state에는 판단에 필요한 텍스트를 넣고, questions에는 질문을 넣는다. 하나의 State에 여러 질문을 보낼 수 있으며, 질문마다 답변 형태와 기준을 정한다.
답변 형태는 세 가지다. 여러 후보 중 하나를 고르면 Choice, 예 또는 아니오로 답하면 Noul, 등급에 따라 평가하면 Score를 사용한다. Primitives (Questions)
| 답변 형태 | 개발자가 정할 것 | 반환값 |
|---|---|---|
Choice | 질문, 선택지와 각 선택지의 의미 | 선택한 항목, 항목별 확률, confidence |
Noul | 예 또는 아니오로 답할 질문 | yes에 대한 확률 |
Score | 질문, 낮은 점수부터 높은 점수까지의 등급 기준 | 점수, 등급별 확률, confidence |
Choice에서는 개발자가 가능한 답을 정한다. Jev는 그중 하나를 고르고 각 항목의 확률도 반환한다. 코드에서는 선택한 항목에 따라 다음 처리를 나눌 수 있다. 다만 선택지 안에서 답한다는 것과 분류가 정확하다는 것은 다르므로, 실제로 맡길 작업에서 품질을 확인해야 한다. Choice
Score에서는 점수별 의미를 정한다. 등급을 세 개 작성하면 순서대로 0, 1, 2점이 된다. 반환되는 점수는 등급별 확률의 가중 평균이므로 소수일 수 있다. 어떤 속성을 평가할지는 질문과 등급 설명에 달려 있다. 설명의 구체성과 문제의 심각도를 평가하고 싶다면 각각 다른 기준을 작성해야 한다. Score
이 글에서 다루는 Jev 1.13은 텍스트를 입력받는다. 화면이나 영상을 활용하려면 먼저 관찰한 내용을 텍스트로 정리해야 한다. 모델을 호출하기 전에 어떤 정보를 전달할 수 있는지부터 확인해야 하는 이유다. Models
리뷰 분류에 적용해보기h2
로그인 기능을 수정한 뒤 다음 리뷰를 받았다고 하자.
요구사항에는 세션 만료 후 로그인 화면으로 이동해야 한다고 적혀 있습니다. 현재 구현에는 이 처리가 없습니다.
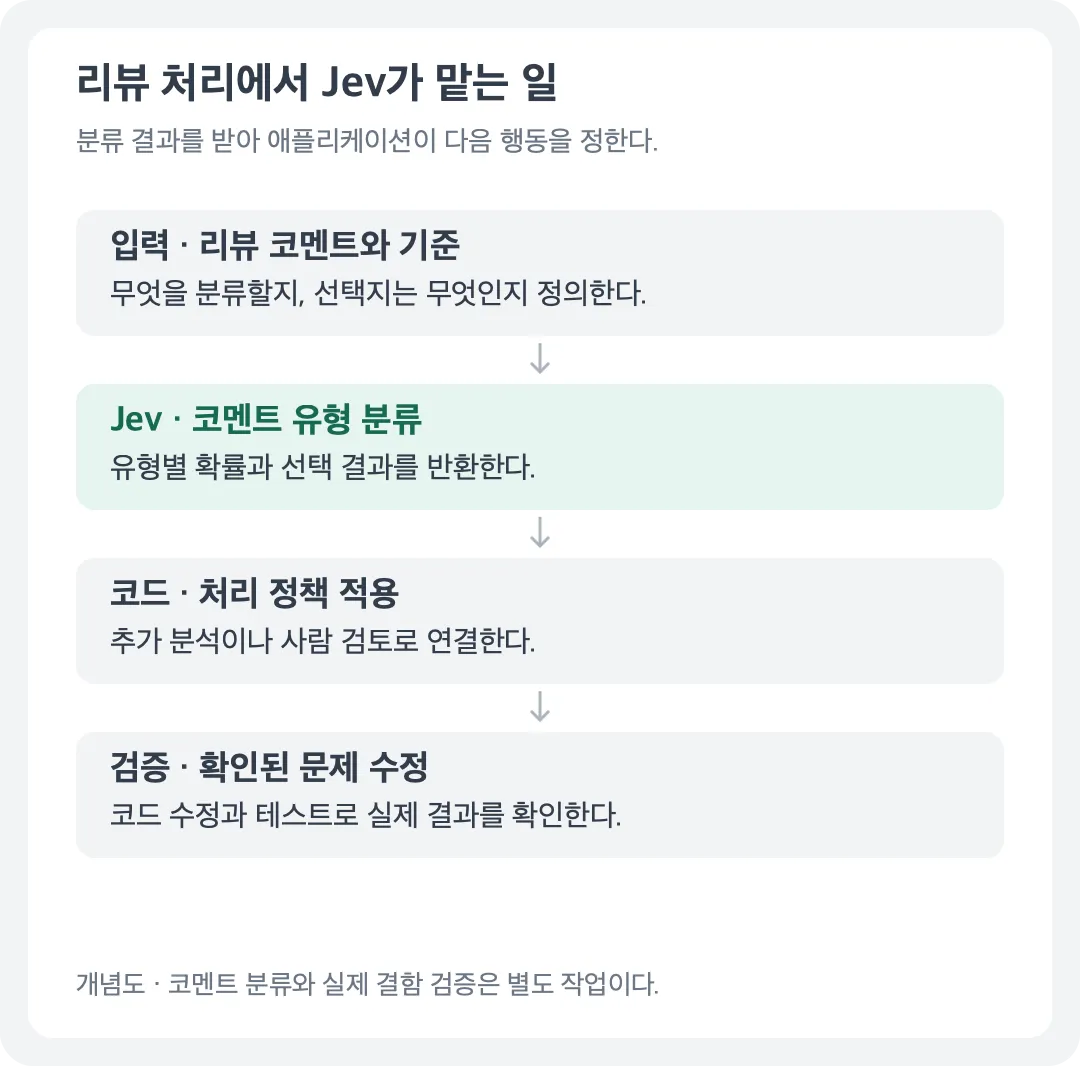
이 코멘트는 요구사항에 적힌 동작이 빠졌다고 지적한다. 에이전트가 리뷰를 모아 처리한다면, 우선 어떤 종류의 요청인지 나눌 수 있다.
BUG 잘못된 동작이나 예외를 지적함MISSING_REQUIREMENT 명시된 요구사항의 미구현을 지적함SUGGESTION 결함 지적 없이 개선을 제안함INSUFFICIENT_INFORMATION 주된 문제를 분류할 정보가 부족함State에는 위 코멘트 원문을 넣고, “이 코멘트가 지적하는 문제는 무엇인가?”라는 Choice 질문에 네 선택지를 붙인다. Jev에 맡겨볼 일은 이 중 하나를 고르는 것이다. 위 코멘트라면 MISSING_REQUIREMENT로 분류할 수 있다. 하지만 코멘트를 읽는 것만으로 실제 구현에 해당 처리가 없는지까지 알 수는 없다. 분류한 뒤 코드를 확인하고, 정말 빠져 있다면 수정하는 과정이 이어져야 한다.
이렇게 나누면 모델이 필요한 곳도 구체적으로 보인다. 테스트 통과 여부와 재시도 횟수는 코드로 확인할 수 있다. 리뷰의 의도를 구분하는 일에는 Jev를 써볼 수 있고, 결함을 찾아 코드를 수정하는 일에는 코드 분석과 생성이 가능한 모델을 사용한다.
기존 분류기와 다른 점은 뭘까h2
분류기(classifier)는 입력을 읽고 미리 정한 범주 중 어디에 속하는지 고르는 모델이다. 메일을 스팸과 정상 메일로 나누는 것이 익숙한 예다. 리뷰 코멘트를 네 종류로 나누는 Jev의 작업도 분류에 해당한다. 그렇다면 기존 분류기 대신 Jev를 검토할 이유는 무엇일까? 새 작업을 추가하는 과정부터 비교해보자.
작업별로 지도학습한 분류기를 만든다고 생각해 보자. 리뷰 유형을 구분할 라벨 데이터를 모으고 학습한 뒤 평가한다. 이후 ‘재현 방법이 있는가’, ‘어느 팀으로 보내야 하는가’라는 판단이 필요해지면 그 작업에 맞는 데이터와 모델 구성을 다시 검토해야 한다. 하나의 모델을 여러 작업에 맞춰 학습할 수도 있지만, 새로운 업무를 정의하고 검증하는 과정은 남는다.
Jev에서는 같은 모델에 질문과 선택지 설명을 바꿔 전달하며 새 작업을 시험할 수 있다. 리뷰 유형을 분류하다가 담당 팀을 고르는 질문을 추가할 때, 개발자가 먼저 새 분류기를 학습시킬 필요가 없다. 모델은 공통으로 사용하고 판단 기준을 요청에 담는 방식이다. 현재 서비스는 사용자별 fine-tuning 없이 동일한 모델 가중치를 사용한다.
예를 들어 팀 구성이 바뀌었다면 해당 요청의 선택지를 FRONTEND, BACKEND, PLATFORM으로 구성할 수 있다. 리뷰 단계와 배포 단계에서 허용하는 행동이 다르다면 단계마다 다른 선택지를 전달할 수 있다. 호출할 때마다 질문과 선택지를 바꿀 수 있다. 작업 단계마다 확인할 내용이 달라지는 에이전트에서 활용하기 좋은 특성이다. 새 모델을 학습하지 않더라도, 바꾼 선택지에 맞춰 평가 데이터를 준비하고 품질을 확인해야 한다.
이런 유연성은 기존 zero-shot 분류와도 비교해야 한다. zero-shot 분류는 해당 작업의 학습 예시 없이, 주어진 분류 기준으로 대상을 나누는 방식이다. 자연어로 표현한 새 라벨을 처리하는 분류는 Jev 이전부터 연구돼 왔다. Jev도 이처럼 새 라벨을 처리할 수 있다. Benchmarking Zero-shot Text Classification: Datasets, Evaluation and Entailment Approach
새 라벨을 처리하는 능력만으로는 차이를 설명하기 어렵다. 함께 제공하는 기능과 모델을 준비하고 운영하는 데 드는 비용까지 비교해보자.
| 비교 대상 | Jev를 검토할 이유 | 함께 확인할 점 |
|---|---|---|
| 작업별 지도학습 분류기 | 새 판단을 질문과 선택지로 정의해 바로 시험할 수 있다 | 고정된 작업과 좋은 라벨이 충분하다면 전용 분류기가 더 적합할 수 있다 |
| zero-shot 분류 모델 | Choice, Score, Noul과 복수 질문을 같은 API에서 조합할 수 있다 | 새로운 라벨 처리 자체는 Jev만의 기능이 아니다 |
| 구조화 출력 LLM | 좁은 판단을 텍스트 생성 없이 확률과 함께 받는 용도로 설계됐다 | 복잡한 분석과 설명 생성이 필요한 작업은 별도로 비교해야 한다 |
| 직접 작성한 규칙 | 규칙으로 열거하기 어려운 문맥 판단을 맡길 수 있다 | 정확한 계산과 명시적 조건은 코드로 처리하는 편이 낫다 |
기존 분류기도 확률을 출력하고 보정할 수 있다. Jev에서는 질문과 선택 기준을 요청에 담고, 여러 결과를 확률과 함께 같은 API로 받는다. 개별 기능의 유무보다, 이 기능들을 묶어 쓰는 방식이 자신의 작업을 얼마나 간단하게 만드는지가 비교할 지점이다.
Jev는 판단 종류가 많고 자주 바뀌어 작업마다 학습 데이터를 모으기 어려울 때 특히 검토할 만하다. 반대로 기준이 안정된 분류 작업을 대량 처리하고 있다면, 기존 분류기보다 나은 점이 있는지부터 확인해야 한다.
Jev는 어떻게 답을 만드는가h2
질문과 선택지를 바꾸는 방식은 알았다. 그런데 범용 LLM에도 같은 질문을 보내고 JSON으로 답하게 할 수 있다. Jev는 답을 만드는 과정에서 무엇이 다를까?
TypeSafe의 설명에서는 출력 방식과 학습 목표를 나눠 볼 수 있다. 병렬 샘플러(parallel sampler)는 여러 결과를 얻는 방식에, RLCD는 판단과 확률을 학습하는 방법에 해당한다. 먼저 출력부터 살펴보자.
병렬 샘플러와 출력 방식h3
먼저 일반적인 자기회귀 LLM의 출력 과정을 보자. 자기회귀 생성은 앞서 생성한 토큰을 바탕으로 다음 토큰을 순서대로 만드는 방식이다. 모델에 세 질문을 한꺼번에 보내고 JSON으로 답하도록 해도, 응답을 구성하는 토큰은 앞선 출력에 이어 생성된다. 출력 형식을 제한하는 것과 이 생성 과정을 바꾸는 것은 다른 일이다.
이를 간단히 쓰면 다음과 같다.
자기회귀 생성입력 → 출력 토큰 1 → 출력 토큰 2 → … → 출력 토큰 T
Jev가 공개한 출력 방식상태 + 질문들 → 질문별 확률분포를 병렬로 출력
TypeSafe는 Jev가 모든 확률을 병렬로 출력한다고 설명한다. 위 도식은 이 출력 방식을 비교한 것으로, 내부 연산 횟수를 뜻하지 않는다. 공개 자료만으로 ‘API 요청 한 번 = 신경망 forward pass 한 번’이라고 결론 내릴 수는 없다.
자기회귀 생성에서는 앞선 출력이 끝나야 다음 출력을 만들 수 있다. 자기회귀 응답은 길이가 늘어나면 순차적으로 생성할 토큰도 늘어난다. Jev는 질문별 판단을 이런 긴 문자열로 작성하는 대신 병렬 출력하도록 설계됐다. 입력 길이에 따른 계산량, 서버 처리와 통신 시간은 여전히 응답시간에 영향을 준다. 질문을 무한히 늘려도 비용과 시간이 같다는 의미는 아니다.
또한 LLM API를 여러 번 병렬 호출하는 방식과도 구분해야 한다. 클라이언트의 동시 호출은 요청 사이의 대기를 줄이지만, 각 요청 안의 자기회귀 출력은 남는다. Jev의 발표는 모델의 출력 방식에 관한 설명이고, 한 상태의 질문을 한 요청에 묶는 것은 그 특성을 사용하는 API 패턴이다.
Jev는 한 요청에 여러 질문을 받을 수 있다h3
이 출력 방식을 사용하는 기능이 복수 질문이다. Jev는 같은 State에 대한 여러 질문을 한 요청으로 받는다. 리뷰의 유형, 설명의 구체성, 재현 방법의 유무를 각각 물어도 된다. 세 질문 모두 원래 코멘트만으로 답할 수 있으므로 앞선 답을 기다릴 필요가 없다.
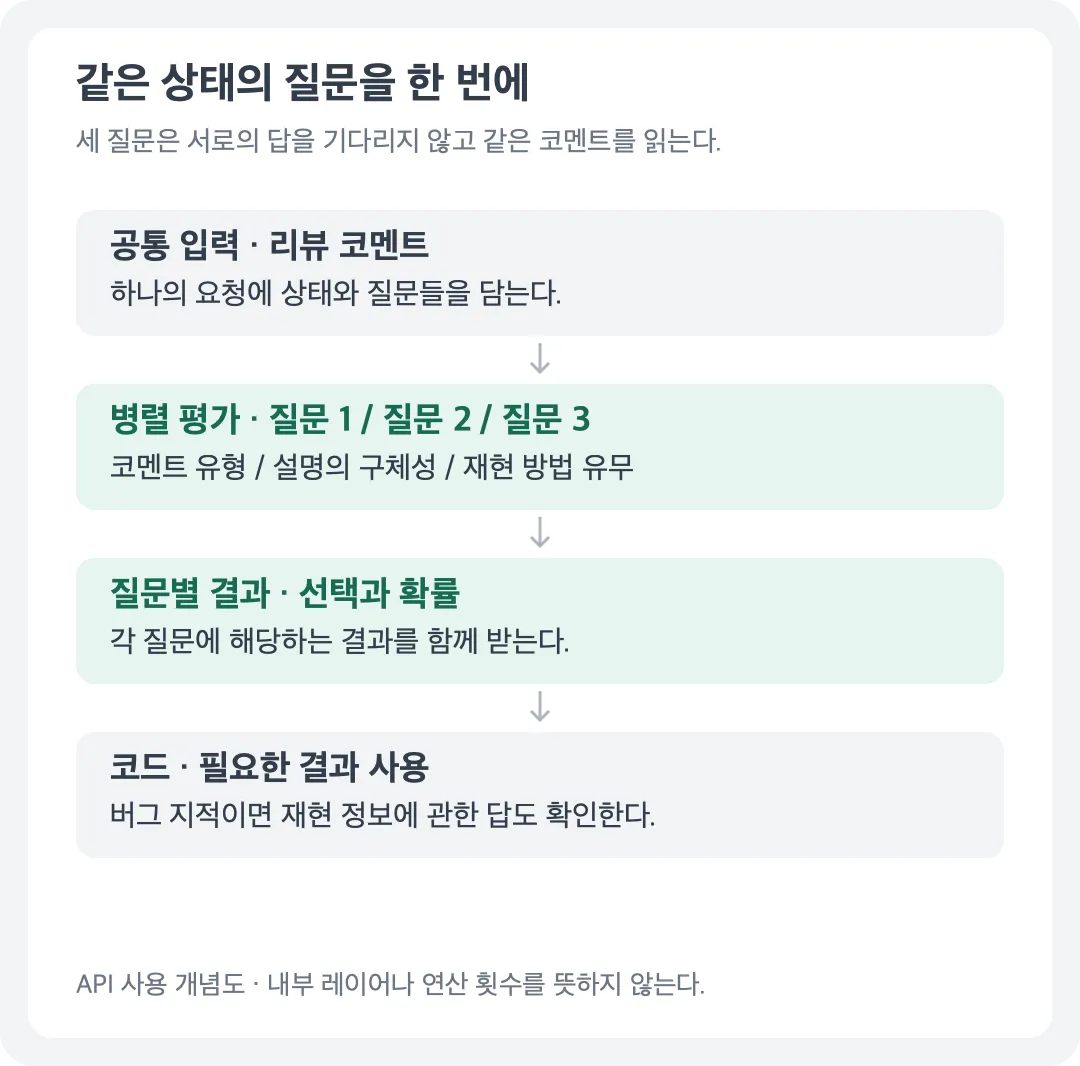
여기서 함께 계산할 수 있다는 것은 앞선 답을 다음 질문의 입력으로 쓸 필요가 없다는 뜻이다. 질문들의 답이 통계적으로 독립이라는 의미는 아니다.
공식 문서는 이런 방식으로 여러 질문을 미리 평가하고 코드에서 필요한 답만 사용하는 패턴을 안내한다. 개선 제안으로 분류된 코멘트라면 재현 방법에 대한 답은 무시할 수 있다. 버그 지적이라면 그 답을 추가 정보 요청 여부에 활용할 수 있다. 어느 답을 사용할지는 나중에 정하지만, 답을 구하는 데 필요한 정보는 처음부터 주어져 있다. Speculative fan-out
반면 첫 판단의 결과에 따라 새 파일을 읽어야 한다면 다음 질문에는 아직 없는 정보가 필요하다. 그때는 파일을 읽은 뒤 다시 호출해야 한다. 병렬 평가가 데이터 의존성을 없애 주지는 않는다.
이 특성은 개발 방식에도 영향을 준다. ‘이 변경을 승인할까?’라는 큰 질문 안에 여러 조건을 숨기는 대신, 확인할 기준을 드러내고 작은 질문으로 나눌 수 있다. 각 질문의 오류를 따로 평가하고, 어떤 조합일 때 다음 단계로 갈지는 코드로 정한다. 질문을 세분화해도 매번 별도 요청을 보낼 필요가 없다는 장점이 있다. 추가 질문도 입력 토큰 비용은 발생한다.
RLCD와 학습 목표h3
병렬 샘플러가 출력을 얻는 방법이라면, RLCD(Reinforcement Learning for Calibrated Decisions)는 판단과 확률을 어떤 목표로 학습할지에 관한 방법이다. TypeSafe는 사전학습된 언어 모델을 후속 학습하는 경로로 RLCD를 설명한다. 사람에게 선호되는 응답이나 검증 가능한 정답을 중심으로 설명하는 RLHF 및 RLVR과 비교해, 판단과 보정된 확률을 출력하도록 학습한다는 점을 강조한다. AI primer
Jev는 질문별 결과를 병렬로 출력하고, 그 결과에 부여하는 확률도 학습 목표에 포함한다. 다만 구체적인 레이어 구성과 손실함수까지 공개된 것은 아니다.
‘추론하지 않는다’는 표현 역시 구분해서 읽어야 한다. Jev도 입력을 처리하고 판단을 계산한다. 자연어로 긴 추론 과정을 생성하는 모델이 아니라는 설명이 적절하다. 이때 반환되는 확률과 confidence도 구별해서 읽어야 한다.
Jev의 확률과 confidenceh2
앞의 코멘트를 분류했을 때 다음 분포를 받았다고 가정하자. 아래는 설명용 임의의 수치다.
BUG 0.08MISSING_REQUIREMENT 0.83SUGGESTION 0.06INSUFFICIENT_INFORMATION 0.03가장 높은 항목은 MISSING_REQUIREMENT다. 이 질문의 choice는 요구사항 누락이 되고, 0.83은 모델이 그 분류에 부여한 확률이다. 질문은 코멘트의 유형에 관한 것이므로, 이 값을 수정의 성공 확률로 사용할 수는 없다.
분류 결과와 확률값의 쓰임h3
사람이 검토할 항목을 순서대로 보여줄 때는 상대적인 순위가 중요할 수 있다. 반면 ‘이 정도로 확실할 때만 자동 처리한다’는 정책에서는 확률값의 크기 자체가 중요하다. 같은 항목을 1위로 골라도, 확률이 0.51일 때와 0.99일 때의 처리 기준은 달라질 수 있다.
확률값을 자동 처리 기준으로 쓰려면 확률 보정(calibration)을 확인해야 한다. 확률 보정은 모델이 제시한 확률이 실제 결과의 빈도와 맞도록 조정하는 과정이다. 예를 들어 충분한 평가 사례에서 80% 안팎의 확률을 받은 예측들을 모았을 때, 실제로도 약 80%가 맞는지 확인한다. 한 사례에서 답을 맞혔다고 보정이 잘됐다고 말할 수 없고, 여러 사례의 전체 정답률만으로도 판단할 수 없다. On Calibration of Modern Neural Networks
정답을 잘 고르는 모델이라도 확률까지 정확하게 제시하는 것은 아니다. 두 모델이 모두 같은 답을 골라도, 틀릴 때 얼마나 강한 확률을 부여했는지는 다를 수 있다. 자동화를 설계할 때는 맞히는 능력과 틀릴 가능성을 적절하게 표현하는 능력이 모두 필요하다.
confidence는 정답률이 아니다h3
Jev의 confidence는 Choice와 Score의 확률분포가 얼마나 한쪽에 모였는지 요약한 값이다. 가장 높은 선택지의 확률과 같은 값도, 실제 정답률을 측정한 값도 아니다. Noul에는 별도의 confidence 필드가 없다. Confidence
따라서 confidence = 0.9를 ‘이 답이 맞을 확률은 90%’라고 그대로 번역할 수 없다. 코드에서 분기 기준으로 쓸 수는 있지만, 정한 기준값에서 실제 오류가 얼마나 발생하는지는 자신의 데이터로 확인해야 한다.
질문에 따른 결과의 일관성h3
확률 보정과 별개로 질문 사이의 일관성도 확인해야 한다. 공식 한계 문서에는 같은 내용을 Noul과 Choice로 표현했을 때 결과가 달라지는 사례, 서로 반대되는 내용을 별도 Noul로 물었을 때 두 값의 합이 1이 되지 않는 사례가 나온다. 이는 한 Choice 안에서 선택지 확률의 합이 1이 되는 것과 다른 문제다. Jev 1.13 jaggedness
실제 서비스에서는 질문 유형과 선택 기준을 정한 뒤 그 조건으로 평가해야 한다. 한 질문에서 검증한 임계값을 다른 유형의 질문으로 옮기거나, 독립적으로 얻은 답들이 자동으로 논리적 관계를 만족한다고 가정해서는 안 된다. 반드시 성립해야 하는 조건은 코드가 관리해야 한다.
자동화 범위와 평가 기준h2
이제 분류 결과와 확률을 바탕으로 자동 처리할 범위를 정할 차례다. 리뷰 분류 도구에서는 먼저 무엇을 정답으로 볼지 정해야 한다. 사람이 코멘트의 주된 의도를 읽고 분류 기준에 따라 라벨을 붙일 수 있다. 요구사항 누락과 버그가 겹치는 경우에는 무엇을 우선할지도 정해야 한다. 기준 자체가 모호하면 모델의 오판과 라벨의 불일치를 구분하기 어렵다.
라벨은 학습 전용이 아니다. 학습에 쓰지 않은 별도의 사례에 라벨을 붙이면 평가 데이터가 된다. 질문을 조정하는 데 사용한 사례와 마지막 품질을 확인할 사례도 분리해야 한다. 같은 사례를 반복해서 보며 기준을 고치면 그 사례에서 잘 맞는다는 사실만 확인하게 될 수 있다.
공식 평가의 범위h3
TypeSafe의 공개 평가는 강한 모델의 판단을 참조값으로 사용한다. 보안 사고, 에이전트 실행 기록, 청구서 처리, 고객 지원이라는 네 workflow를 구성하고, 각 workflow의 좁은 질문에 대한 강한 모델들의 응답을 참조값으로 삼는다. 공식 설명상 참조 모델은 고추론 설정의 GPT-6 Astra와 Claude Fable 5.1이며, 비교 대상 모델은 제공자의 기본 추론 설정으로 평가한다. Workflow evals
이 결과로 알 수 있는 것은 정해진 workflow와 참조값을 기준으로 한 일치도, 비용, 처리 시간이다. 실제 고객 문의가 해결됐는지나 잘못된 청구서가 지급되지 않았는지를 직접 관찰한 결과와는 구분해야 한다. 참조 모델의 판단이 틀리거나 편향될 가능성도 남는다. 또한 평가에 쓰였다는 사실만으로 그 모델이 Jev의 학습 데이터를 만든 교사 모델이었다고 결론 낼 수는 없다.
리뷰 데이터 평가 기준h3
공식 평가를 참고한 뒤에는 자신의 작업에서 다음 세 질문에 답해야 한다.
| 평가 질문 | 확인할 내용 |
|---|---|
| 분류가 맞는가? | 별도 평가 데이터의 정답률과 유형별 오류 |
| 확률값이 실제 결과와 맞는가? | 확률 구간별 실제 빈도와 신뢰도 곡선 |
| 자동 처리했을 때 이득이 있는가? | 자동 처리 비율, 그 안의 오류율, 재검토와 실패 비용 |
확률 예측의 전반적인 품질은 Brier score와 log loss로 함께 평가할 수 있다. 두 지표는 보정만을 따로 측정하지 않으므로, 확률 구간별 실제 빈도도 함께 확인한다. 선택만 맞으면 같은 점수를 주는 정답률과 달리, 틀린 결과에 지나치게 높은 확률을 부여한 경우도 구분할 수 있다. 이런 확률 예측 평가법은 Jev 이전부터 연구돼 왔다. Strictly Proper Scoring Rules, Prediction, and Estimation (Revised)
업무에 적용할 때는 오류의 종류도 중요하다. 개선 제안을 필수 수정으로 보내면 불필요한 작업이 생긴다. 요구사항 누락을 개선 제안으로 보내면 필요한 수정이 빠질 수 있다. 정답률이 같아도 어느 쪽을 자주 틀리는지에 따라 도입 판단은 달라진다.
자동 처리 범위와 오류율은 함께 봐야 한다. 다음은 Jev의 실측 성능이 아닌 가상의 운영 결과다.
| 항목 | 건수 또는 비율 |
|---|---|
| 전체 리뷰 | 1,000건 |
| 자동 처리 | 800건 (전체의 80%) |
| 사람 검토 | 200건 (전체의 20%) |
| 자동 처리 중 오류 | 8건 (자동 처리한 건의 1%) |
이 경우 자동 처리한 80%에서 발생한 오류 비용과, 나머지 20%를 검토하는 비용을 함께 계산해야 한다. 임계값을 바꿔 자동 처리 비율을 줄였을 때 실제 오류도 줄어드는지 비교한다. 전체 요청을 처리한 모델의 정확도와 일부만 자동 처리한 시스템의 오류율은 분모가 다르므로 직접 비교할 수 없다. 이런 처리 비율과 위험의 관계 역시 기존 선택적 예측 연구의 주제다. SelectiveNet: A Deep Neural Network with an Integrated Reject Option
이 평가 방식은 다른 분야에도 적용할 수 있다. 다만 무엇을 성공으로 볼지는 각 업무에서 다시 정해야 한다. 코딩에서는 테스트 통과가 유용한 관측값이지만 모든 요구사항 충족을 뜻하지는 않는다. 모델의 판단, 뒤에 실행한 행동, 실제 결과를 각각 기록해야 어디에서 문제가 생겼는지 알 수 있다.
단일 호출 비용과 워크플로우 기준 전체 비용h2
맡길 작업에서 필요한 품질이 나온다면, 다음으로는 비용을 비교할 차례다. 토큰당 가격으로 한 번의 호출 비용을 계산하고, 그 호출을 바꿨을 때 전체 작업에서 얼마나 절약되는지 살펴보자.
작성일 기준 공식 문서에서 확인되는 Jev 1.13의 가격은 입력 100만 토큰당 0.042달러이며 출력은 무료다. TypeSafe는 공개 발표에서 70~500ms의 응답시간도 제시했다. 가격은 공식 요금이고, 응답시간은 회사가 제시한 측정치다. 입력 길이와 네트워크 조건이 다른 자신의 환경에서도 동일하게 나온다고 전제할 수는 없다.
리뷰 분류를 Jev로 바꾸면 이 단가 차이가 전체 비용에도 그대로 반영될까. 먼저 전체 작업에서 교체 가능한 판단 비용이 차지하는 비중을 알아야 한다. 기존 비용이 100이고 그중 판단 작업이 35라고 가정하자. 판단 작업의 비용이 100분의 1이 되더라도 총비용은 다음처럼 계산된다.
변경하지 않은 작업 65교체한 판단 작업 35 × 0.01 = 0.35전체 비용 65.35절감률 약 34.7%판단 호출만 크게 저렴해졌고, 생성과 복잡한 분석 비용은 그대로 남아 있기 때문이다. 이 계산은 가정에 따른 예시다. 실제로 얼마를 줄일 수 있는지는 호출 로그에서 판단 작업의 비중을 확인하고 계산해야 한다. 호출 횟수의 비중과 비용의 비중도 같지 않다.
분류 오류 때문에 상위 모델을 다시 호출했다면 그 비용을 더해야 한다. 사람의 검토, 재시도, 입력을 정리하는 전처리도 포함된다. 입력 토큰 수가 같아도 단가가 달라 비용은 줄 수 있으므로, ‘토큰을 줄였다’와 ‘비용을 줄였다’는 별도로 기록하는 편이 정확하다.
절감 방법이 기존 호출 교체에만 있는 것은 아니다. 검색 결과를 먼저 평가해 필요한 문서만 LLM에 전달하면 뒤의 모델이 읽는 입력을 줄일 수 있다. TypeSafe도 문서 선별 예제를 제공한다. 다만 필요한 근거를 걸러내면 뒤의 모델은 그 정보를 복구할 수 없다. 입력량뿐 아니라 최종 답변의 품질도 함께 비교해야 한다. Classifying RAG passages
같은 상태에 대한 질문을 하나의 요청에 묶는 방법도 있다. 반복해서 상태를 보내는 양과 요청 왕복을 줄일 수 있다. 하지만 추가 질문의 텍스트까지 무료가 되는 것은 아니다. 병렬 처리의 효과와 입력 과금은 별개의 문제다.
반복 실행하는 에이전트에서는 최종 완료 시간도 측정할 필요가 있다. 개별 판단 호출이 빨라져도 재작업이 늘어나면 전체 시간은 길어질 수 있다. 도입 전후에는 같은 작업의 최종 품질, 총비용, 완료 시간을 비교한다.
이외의 사용처h2
리뷰 코멘트는 판단의 입력과 출력을 설명하기 위한 예제다. 같은 구조를 고객 문의, 검색 결과, 문서 묶음, 상품 데이터에도 적용할 수 있다. 중요한 것은 분야보다 문맥을 읽어 정해진 후보를 고르거나 기준에 따라 평가하는 단계가 있는가다.
아래는 작성일 기준 공식 예제와 공개 프로젝트에서 확인한 사용처다. 직접 성능을 검증한 사례나 대규모 운영 성과는 아니다. RAG와 상품 비교 예제에는 Jev 1.12로 기록한 결과가 포함돼 있어, 이번 실습과 성능을 직접 비교할 수는 없다.
| 사용처 | Jev에 맡기는 판단 | 뒤에서 이어지는 처리 | 확인한 자료 |
|---|---|---|---|
| 고객 지원과 메일 분류 | 요청의 의도와 적합한 처리 경로 | 코드, 전문 모델, 담당자에게 전달 | 공식 intent routing |
| 검색과 RAG | 질문과 문서의 관련성, 근거 여부, 전제와의 충돌 | 근거 문서를 구성하고 LLM이 답변 작성 | 공식 문서 선별 예제 |
| 문서 분류와 분리 | 문서 종류와 문서 사이의 경계 | 페이지 범위별로 분리해 저장 | DocJev 공개 프로젝트 |
| 상품과 데이터 정리 | 두 레코드가 같은 대상을 설명하는지 | 연결하거나 병합할 후보를 정해 검토 | 공식 entity alignment 예제 |
| 콘텐츠와 답변 검토 | 정책 위반 가능성, 인용 근거의 적합성 | 통과, 차단, 재검토 | 공식 guardrails 예제, 인용 검증 예제 |
| 브라우저 자동화 | 현재 페이지에서 수행할 동작과 대상 | 브라우저 도구가 실행하고 결과 확인 | Jev Ultrafast 공개 프로젝트 |
| 게임 에이전트 | 현재 상태에서 가능한 다음 행동 | 게임 제어 코드가 이동이나 채집 등의 행동 실행 | Jev Minecraft 공개 프로젝트 |
고객 문의를 분류한 뒤 결제 내역을 조회하거나, 관련 문서를 고른 뒤 답변을 작성하는 식으로 활용할 수 있다. 문서 분류처럼 텍스트 추출이 먼저 필요한 작업도 있다. Jev에 맡길 단계를 정할 때는 입력을 준비하는 과정과 결과를 실행하는 과정까지 함께 봐야 한다. 정책 검사나 인용 검증 역시 통과했다는 결과만으로 안전성이나 출처의 사실성까지 보장하지는 않는다.
Jev Engineeringh2
여러 사용처를 보면 개발자가 해야 할 일도 비슷하다. 필요한 정보를 모으고, 모델에 물을 질문을 정하고, 답을 받은 뒤 실행할 작업을 연결한다. Jev API를 호출하는 코드는 이 과정의 일부다. 이런 구성을 커뮤니티에서는 어떻게 설명하고 있을까?
Made with Jev는 LLM에 작성, Jev에 판단, 코드에 실행을 맡기는 구성을 ‘Jev Engineering’으로 소개한다. 이 글에서도 이 표현을 생성과 판단, 실행의 역할을 나누는 커뮤니티의 설계 관점으로 사용한다. What is Jev Engineering?
Jev를 호출하기 전에 개발자는 어떤 정보를 보내고, 무엇을 물으며, 답을 어떻게 구분할지 정해야 한다. 리뷰 처리에 적용하면 다음과 같다.
| 설계할 부분 | 리뷰 처리의 예 |
|---|---|
| 상태 | 코멘트 원문, 관련 요구사항, 실제 테스트 결과를 구분해 전달한다 |
| 질문 | 코멘트의 유형을 묻는 일과 주장의 사실 여부를 검증하는 일을 분리한다 |
| 선택 기준 | 버그와 요구사항 누락이 겹칠 때 무엇을 우선할지 정한다 |
분류 결과가 기대와 다르면 이 세 부분을 따로 살펴볼 수 있다. 근거가 빠졌다면 상태를 보완하고, 여러 일을 한꺼번에 물었다면 질문을 나누고, 선택지가 겹친다면 기준을 고친다. 수정한 질문은 남겨 둔 평가 사례로 다시 확인한다.
질문을 정했다면 이제 답을 어디에 쓸지 정할 차례다. 요구사항 누락으로 분류된 코멘트를 바로 수정 요청으로 넘겨도 될까?
모델에 물을 일과 코드로 처리할 일h2
테스트가 실패했는지, 재시도를 세 번 넘겼는지는 코드로 확인할 수 있다. 이런 조건까지 모델에 물으면 비용이 들고 잘못된 답을 받을 여지도 생긴다. 반면 리뷰가 버그를 지적하는지 개선을 제안하는지는 문맥을 읽어야 한다. Jev를 써볼 곳은 이쪽이다.
모델이 분류한 뒤의 처리도 코드로 정한다. 요구사항 누락으로 분류됐다면 실제 구현과 요구사항을 대조하고, 누락이 확인되면 수정을 요청한다. 테스트가 실패한 채로 승인을 진행하지 않거나 같은 수정이 반복되면 멈추는 조건은 모델의 답과 무관하게 적용한다. 이렇게 모델의 분류와 코드의 조건문을 연결하는 것이다.
앞선 리뷰 흐름의 처리 정책을 펼쳐 보면 다음과 같다. 실제 제품의 구현이 아닌, 리뷰 처리의 역할 분담을 나타낸 설계 예시다.
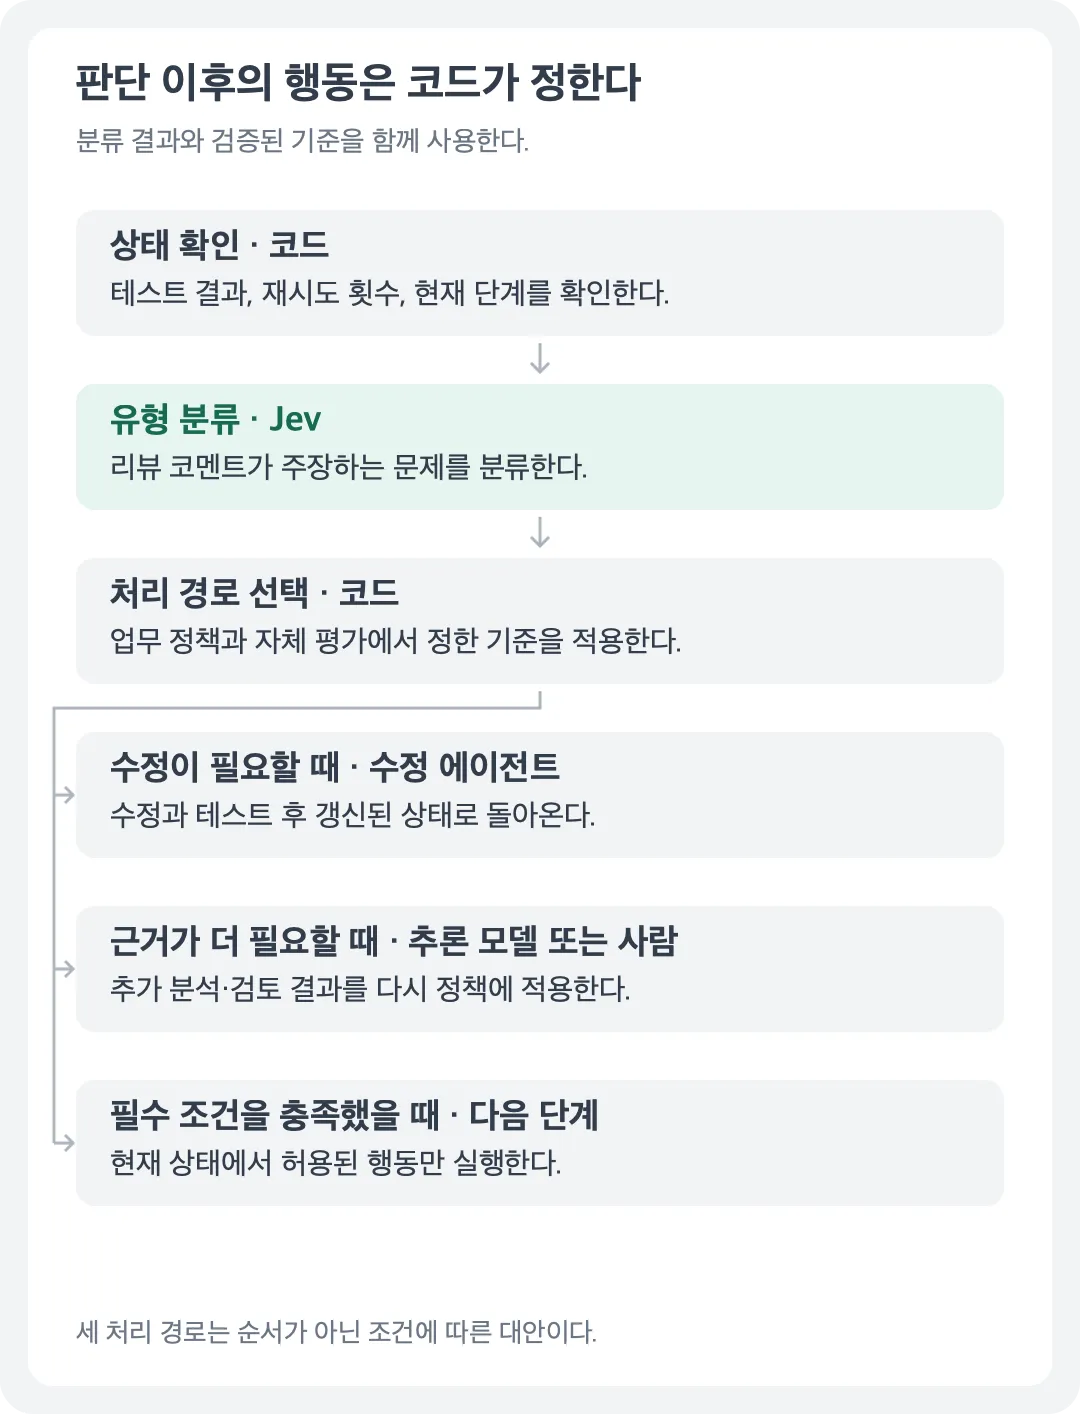
이 구조에서 모델이 판단에 참여해도 상태 전환의 조건은 코드에 남는다. 테스트가 실패하면 다음 단계로 보내지 않기, 같은 수정을 일정 횟수 이상 반복하지 않기, 특정 변경은 사람 검토를 거치기 같은 조건이다. 모델의 선택을 실행하기 전에 현재 상태에서 허용되는 행동인지 확인한다.
선택지가 적다는 사실만으로 Jev에 적합한 문제인 것은 아니다. “이 변경에 보안 취약점이 있는가?”는 yes 또는 no로 답할 수 있지만 여러 파일과 실행 경로의 분석을 요구할 수 있다. 반대로 “이 코멘트가 보안 문제를 지적하는가?”는 코멘트에 표현된 의도를 분류하는 일이다. 답변의 길이보다 답을 얻는 데 필요한 작업이 중요하다.
공식 한계 문서도 산술, 날짜 비교, 여러 단계의 간접 조건, 불필요한 문맥, 적대적으로 작성된 입력에서 문제가 생길 수 있다고 설명한다. 정확한 계산은 코드에 두고, 모델에는 판단에 필요한 정보를 명확히 전달하는 이유다.
정보 부족이나 사람 검토를 선택지에 추가하는 것만으로 모든 실패를 처리할 수는 없다. 낯선 입력에서도 모델은 자신 있게 틀릴 수 있다. 낮은 confidence만 기다리는 정책은 그런 오류를 놓친다. 명확한 사례 외에 맥락이 빠진 사례, 기준이 겹치는 사례, 표현이 달라진 사례를 평가에 넣어야 한다.
오류를 조사할 방법도 필요하다. Jev는 판단의 이유를 자연어로 작성하는 모델이 아니다. 다른 LLM에 결과를 설명하게 할 수는 있지만, 그 설명이 Jev가 실제로 판단한 내부 근거라는 보장은 없다. 오류를 추적하려면 원래 상태와 질문, 모델 버전, 반환값, 코드가 실행한 행동을 함께 기록해야 한다.
이런 역할 분담이 Jev 때문에 처음 가능해진 것은 아니다. 기존 에이전트 설계에서도 분류와 라우팅, 코드가 정한 workflow가 사용됐다. 기존에 LLM이나 분류기에 맡기던 작업에 Jev도 사용해볼 수 있다. Building effective agents
사용자는 같은 코딩 도구를 쓰더라도, 내부에서는 작업에 따라 서로 다른 모델이나 코드를 호출할 수 있다.
예시로 알아보는 Jev 적용 과정h2
개발팀에 들어오는 이슈를 정리하는 도구를 만든다고 하자. 어떤 종류의 문제인지 나누고, 담당자가 내용을 읽고 바로 확인할 수 있을지도 알아보고 싶다. 다음 이슈를 예로 요청을 구성한 뒤 응답을 다음 작업에 연결해보자.
로그인한 뒤 네트워크를 끄고 저장 버튼을 누르면 로딩 표시가 사라지지 않습니다. 네트워크를 다시 연결해도 그대로입니다.
1. 요청을 만들고 응답 활용하기h3
먼저 State에 원문을 넣는다. 지금 알아볼 것은 이슈의 유형과 설명에 담긴 정보다. 코드나 실행 결과는 아직 없으므로 이슈 원문만 보낸다. 다음 JSON은 요청을 조립하는 중간 모습이다.
{ "state": "로그인한 뒤 네트워크를 끄고 저장 버튼을 누르면 로딩 표시가 사라지지 않습니다. 네트워크를 다시 연결해도 그대로입니다.", "questions": {}}문제 유형을 고를 Choice 질문을 추가한다. questions 안에 q1이라는 키를 만들고, 질문 문장과 답으로 받을 항목을 넣는다. 선택지는 버그, 요구사항 누락, 개선 제안, 정보 부족이다. criteria의 값에는 각 항목의 설명을 넣을 수 있다. 여기서는 Playground에 입력했던 이름만 옮겨 설명은 null로 두었다.
{ "state": "로그인한 뒤 네트워크를 끄고 저장 버튼을 누르면 로딩 표시가 사라지지 않습니다. 네트워크를 다시 연결해도 그대로입니다.", "questions": { "q1": { "type": "choice", "instructions": "이 리뷰 코멘트가 지적하는 주된 문제는 무엇인가요?", "criteria": { "BUG": null, "MISSING_REQUIREMENT": null, "SUGGESTION": null, "INSUFFICIENT_INFORMATION": null } } }}담당자가 따라 할 조작 순서가 있는지도 묻는다. “코멘트에 문제를 재현하기 위한 구체적인 조작 순서가 명시되어 있나요?”는 예 또는 아니오로 답할 수 있다. questions에 다음 q2 항목을 추가한다. Playground의 Boolean에 해당하는 API 유형은 noul이다.
{ "q2": { "type": "noul", "instructions": "코멘트에 문제를 재현하기 위한 구체적인 조작 순서가 명시되어 있나요?" }}설명의 구체성은 Score로 평가한다. q3에 질문과 다섯 등급을 넣는다. ‘없음’부터 ‘확실히 명확’까지 나열한 순서가 0~4점이 된다. 문제의 심각도가 아니라 설명이 얼마나 명확한지를 묻는 기준이다.
세 질문을 합치면 다음과 같다. State는 한 번만 넣고, 같은 원문에 대한 질문을 questions에 쌓는다. 이 JSON은 확인된 실습 입력을 API 형식으로 정리한 요청 본문 예시다. Playground가 전송한 원본 네트워크 요청은 아니다. 입력 형식은 공식 Quick start에서도 확인할 수 있다.
{ "state": "로그인한 뒤 네트워크를 끄고 저장 버튼을 누르면 로딩 표시가 사라지지 않습니다. 네트워크를 다시 연결해도 그대로입니다.", "questions": { "q1": { "type": "choice", "instructions": "이 리뷰 코멘트가 지적하는 주된 문제는 무엇인가요?", "criteria": { "BUG": null, "MISSING_REQUIREMENT": null, "SUGGESTION": null, "INSUFFICIENT_INFORMATION": null } }, "q2": { "type": "noul", "instructions": "코멘트에 문제를 재현하기 위한 구체적인 조작 순서가 명시되어 있나요?" }, "q3": { "type": "score", "instructions": "이 리뷰 코멘트의 문제 설명은 얼마나 구체적인가요?", "criteria": [ "없음", "막연함", "조금 명확", "대체로 명확", "확실히 명확" ] } }}이 질문들로 받은 결과를 읽어보자. 아래는 Jev Playground에서 받은 실제 응답이다. 질문의 q1, q2, q3 키가 응답의 answers에도 그대로 나타난다.
{ "answers": { "q1": { "type": "choice", "choice": "BUG", "probabilities": { "BUG": 1, "MISSING_REQUIREMENT": 0, "SUGGESTION": 0, "INSUFFICIENT_INFORMATION": 0 } }, "q2": { "type": "boolean", "probability": 0.93 }, "q3": { "type": "score", "score": 3.61, "probabilities": { "0": 0, "1": 0, "2": 0.01, "3": 0.37, "4": 0.62 } } }, "usage": { "inputTokens": 529, "outputTokens": 91, "totalTokens": 620 }, "confidence": { "q1": 1, "q3": 0.68 }, "warnings": []}q1은 BUG를 골랐고, 반환된 확률도 이 항목에 모두 몰렸다. 코멘트가 버그를 지적한다는 분류 결과다. 실제 코드의 결함을 확인한 것은 아니다. q2는 재현 절차가 있다는 쪽에 0.93의 확률을 부여했다. 로그인, 네트워크 끄기, 저장 버튼 누르기라는 조작 순서가 입력에 담겨 있다.
q3의 점수는 3.61이다. ‘대체로 명확’에 0.37, ‘확실히 명확’에 0.62의 확률을 부여했고, ‘조금 명확’에도 0.01이 남았다. 이 분포의 가중 평균을 구하면 반환된 점수와 일치한다.
2 × 0.01 + 3 × 0.37 + 4 × 0.62 = 3.61여기서 가장 높은 등급의 확률은 0.62이고, q3의 confidence는 0.68이다. 앞에서 설명한 것처럼 두 값은 같지 않다. confidence가 0.68이라고 해서 이 평가가 맞을 확률이 68%라는 뜻도 아니다. 이 응답에서는 confidence가 각 답변 안이 아니라 별도의 객체에 질문별로 담겨 있다.
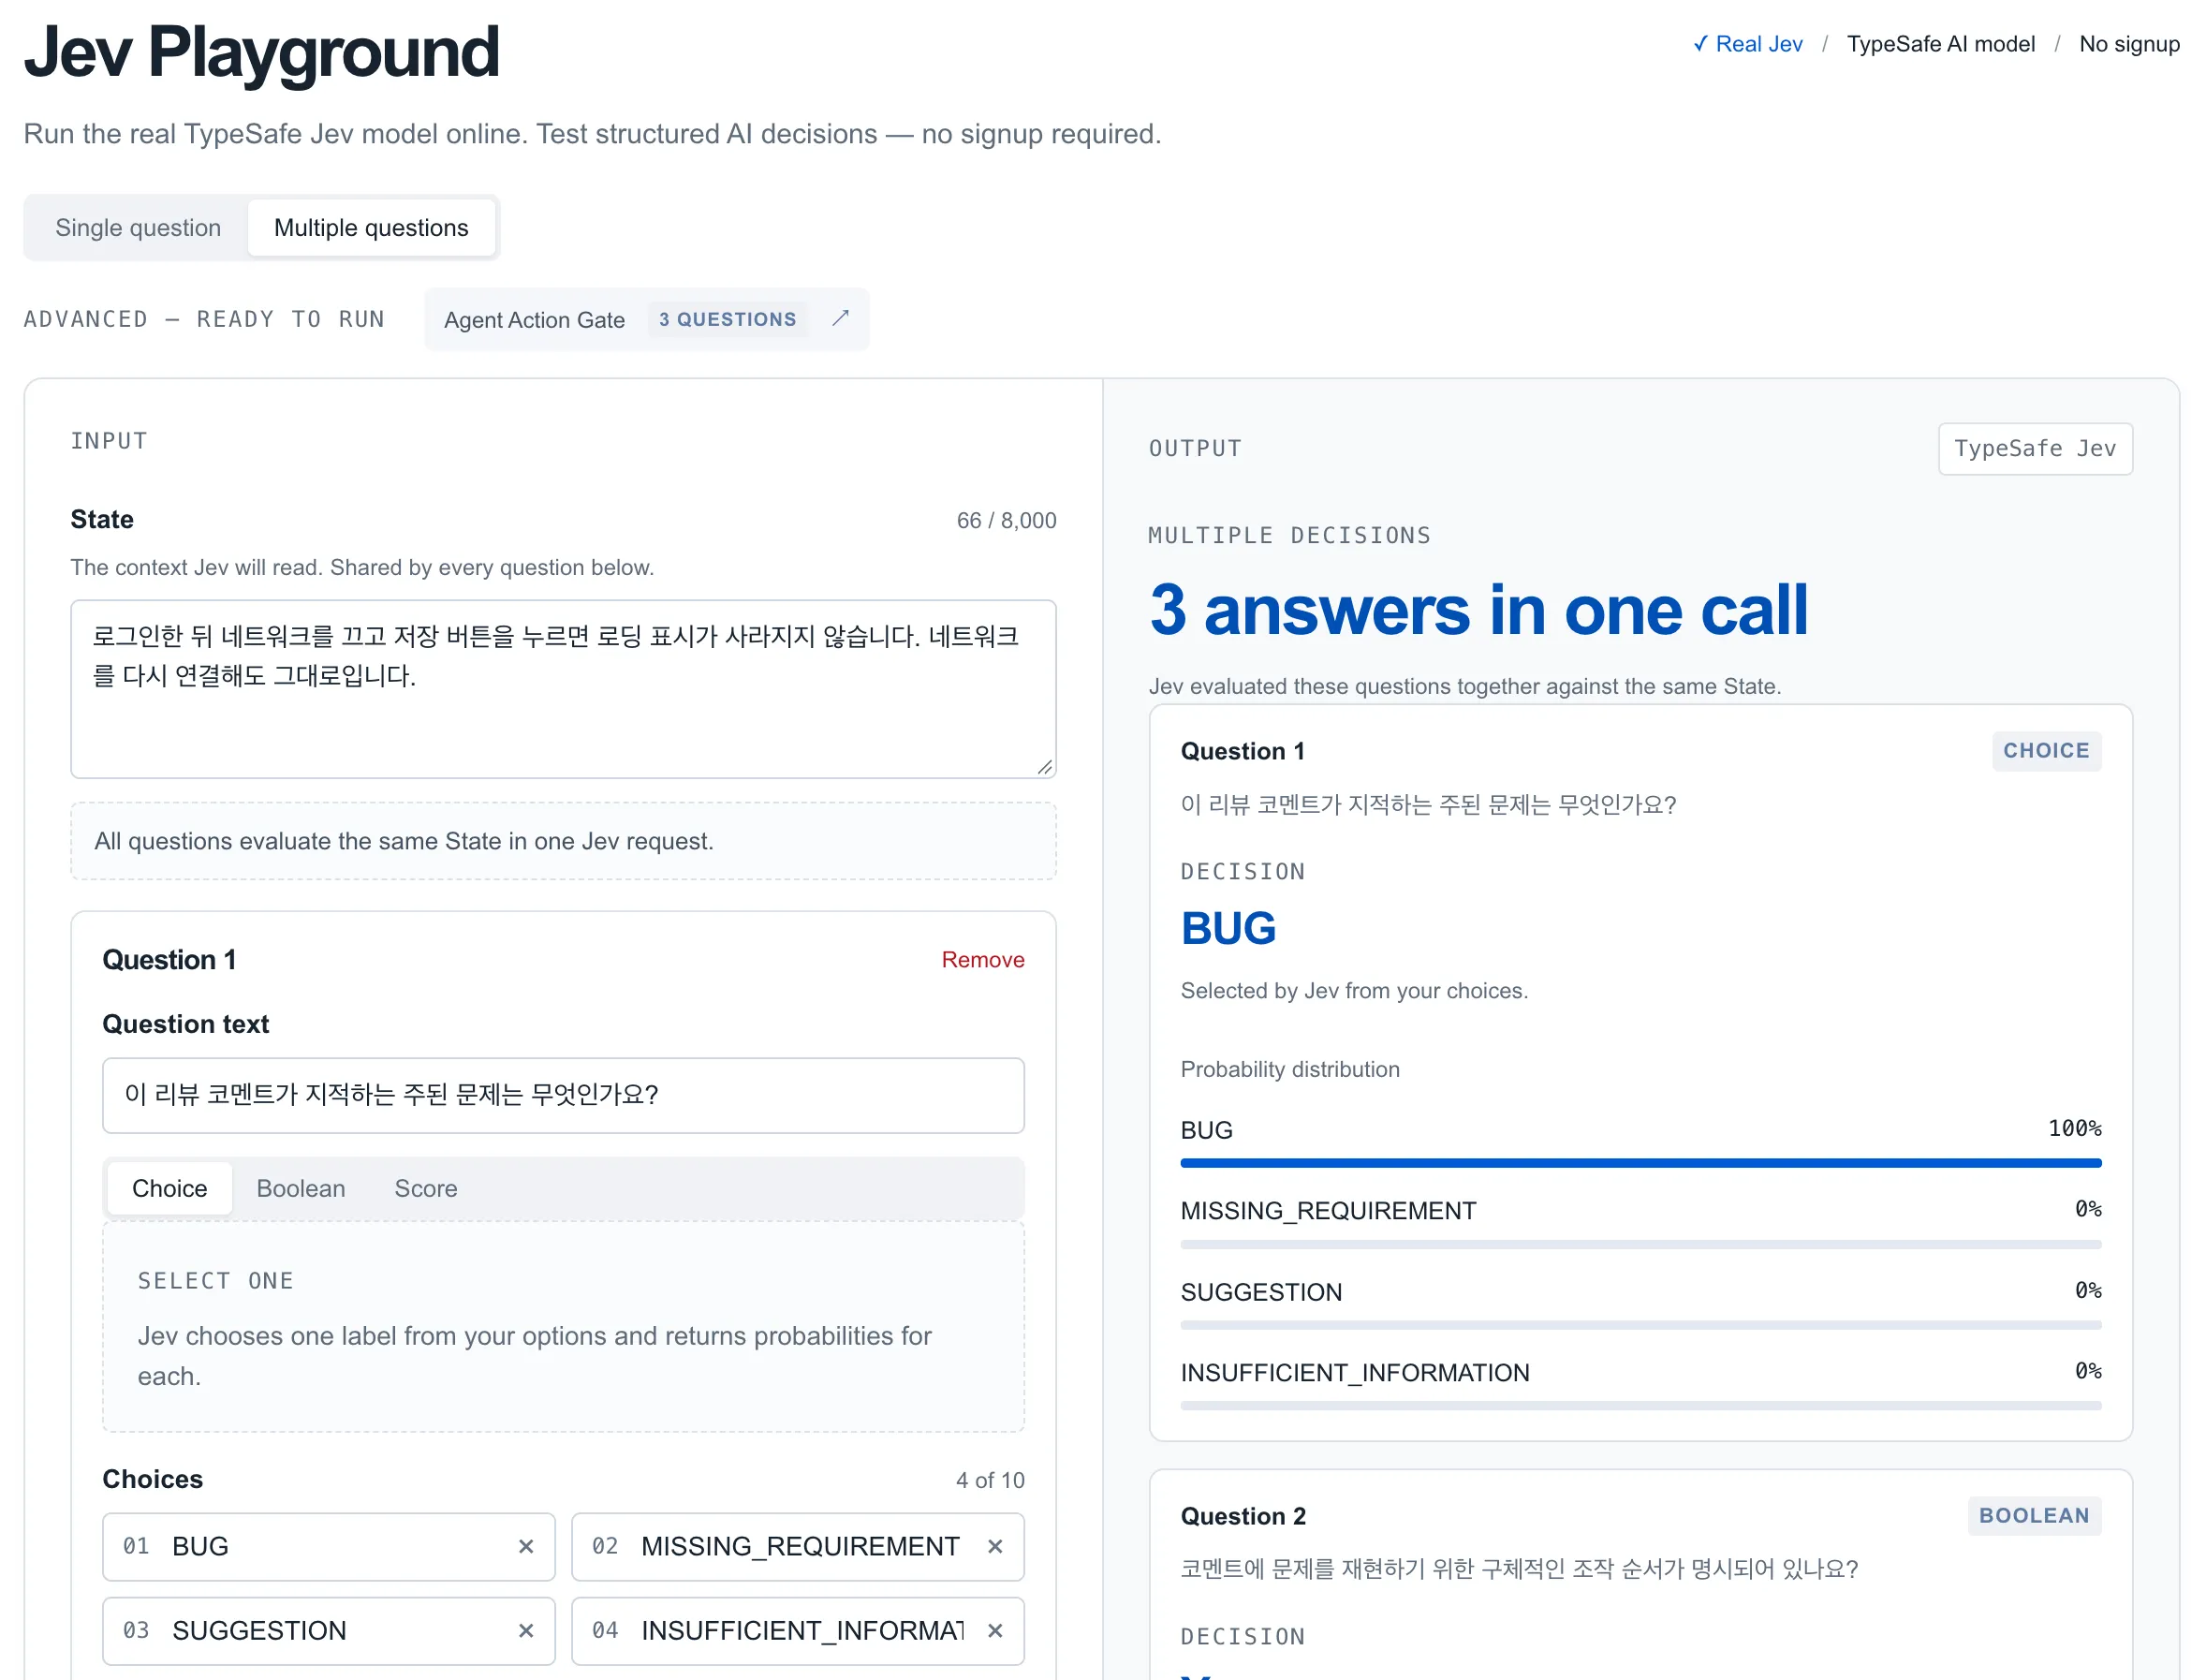
이제 담당자가 할 일을 정한다. BUG라는 결과만 보고 곧바로 수정을 요청할 필요는 없다. 먼저 이슈에 적힌 조작을 따라 해 같은 증상이 나타나는지 확인하고, 그 뒤에 원인을 조사하면 된다. 재현에 필요한 설명이 부족하다면 작성자에게 정보를 더 요청한다.
이 예제에서는 조작 순서가 있을 확률이 0.9 이상이고 구체성이 3 이상이면 확인을 시작하도록 정해보자. 두 조건을 함께 쓰는 이유는 순서가 적혀 있어도 어떤 증상이 문제인지 불분명할 수 있고, 증상이 명확해도 따라 할 순서가 없을 수 있기 때문이다. 0.9와 3은 동작을 설명하기 위한 예시 기준이며, 실측으로 검증된 임계값은 아니다.
받은 값은 BUG, 0.93, 3.61이다. 두 조건을 모두 충족하므로 담당자가 ‘로그인 → 네트워크 끄기 → 저장 버튼 누르기’를 따라 확인하는 작업으로 보낸다. 여기서 0.93은 절차가 있다는 응답이지, 버그 재현에 성공할 확률은 아니다.
def route_review(kind, reproduction_probability, clarity):    if kind == "INSUFFICIENT_INFORMATION":        return "REQUEST_DETAILS"    if kind == "SUGGESTION":        return "REVIEW_SUGGESTION"    if kind == "MISSING_REQUIREMENT":        return "VERIFY_REQUIREMENT"    if kind == "BUG":        if reproduction_probability >= 0.9 and clarity >= 3:            return "REPRODUCE_BUG"        return "REQUEST_DETAILS"    return "HUMAN_REVIEW"

# Playground에서 받은 값으로 분기 확인assert route_review("BUG", 0.93, 3.61) == "REPRODUCE_BUG"
# 위 Playground 응답의 값을 적용next_step = route_review("BUG", 0.93, 3.61)print("다음 처리:", next_step)MISSING_REQUIREMENT라면 요구사항과 구현을 대조하고, SUGGESTION이라면 개선 제안 검토 목록으로 보낸다. INSUFFICIENT_INFORMATION은 추가 설명을 요청할 목록에 넣는다. API 호출 실패는 정상적인 분류 결과와 섞지 않고 호출부에서 별도로 처리한다. 모델이 이슈를 읽고, 코드는 결과에 맞는 작업을 연결하는 흐름이다.
2. 코드에서 호출하기h3
공식 SDK는 Python과 JavaScript/TypeScript로 제공된다. 사용하는 언어에 맞춰 아래 저장소의 설치 방법과 예제를 참고하면 된다.
| 언어 | 패키지 | 공식 저장소 |
|---|---|---|
| Python | typesafe-sdk | typesafe-sdk-python |
| JavaScript / TypeScript | @typesafe-ai/sdk | typesafe-sdk-js |
JavaScript/TypeScript SDK는 Node.js 20 이상에서 사용할 수 있다. TypeSafeClient의 systemOne()으로 요청하고, response.answers에서 질문별 결과를 읽는다. 아래에서는 앞의 분기 함수에 이어 붙일 수 있도록 Python으로 호출한다. 두 SDK 모두 API 키는 서버의 TYPESAFE_API_KEY 환경변수에 둔다.
앞에서 완성한 요청 JSON을 request.json으로 저장하면 같은 내용을 Python SDK로 보낼 수 있다. Python 3.10 이상에서 SDK를 설치하고 API 키를 TYPESAFE_API_KEY 환경변수에 설정한다. 다음 코드는 공식 SDK 사용법을 바탕으로 작성했다. Usage
python -m pip install typesafe-sdkimport jsonfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient
with open("request.json", encoding="utf-8") as file: payload = json.load(file)
q1, q2, q3 = (payload["questions"][key] for key in ("q1", "q2", "q3"))questions = { "q1": Choice(instructions=q1["instructions"], criteria=q1["criteria"]), "q2": Noul(instructions=q2["instructions"]), "q3": Score(instructions=q3["instructions"], criteria=q3["criteria"]),}with TypeSafeClient() as client: result = client.system_one(state=payload["state"], questions=questions)
# 앞에서 정의한 route_review 함수에 SDK 응답을 연결next_step = route_review( result.choices["q1"].choice, result.nouls["q2"].noul, result.scores["q3"].score,)print("다음 처리:", next_step)위 코드와 앞의 route_review 함수를 같은 파일에 두면 된다. 코딩 에이전트로 연동 코드를 작성한다면 TypeSafe의 공식 agent skill도 참고할 수 있다. API 사용법을 안내하는 자료이며, 설치만으로 기존 모델 호출이 Jev로 바뀌지는 않는다. Jev with coding agents
3. 자신의 데이터로 비교하기h3
응답에서는 choice만 보지 말고 probabilities와 confidence를 함께 읽는다. 명확한 입력을 “이 부분은 다시 봐야 할 것 같습니다”처럼 바꿨을 때 정보 부족을 고르는지, 여러 항목에 확률을 나누는지, 한 항목으로 강하게 몰리는지 확인한다. 실제 응답을 기록하고 처음 입력의 결과와 비교해보자.
세 질문이 입력의 변화에 어떻게 반응하는지도 비교할 수 있다. 조작 순서만 지우고 증상을 남겼을 때 버그 분류는 유지되는지, 재현 절차가 있다는 확률과 구체성 점수는 어떻게 달라지는지 확인한다.
가장 유용한 테스트는 지금 사용하는 워크플로우에서 실제로 겪는 문제를 가져오는 것이다. LLM이 자주 잘못 분류하는 문의나 매번 사람이 다시 확인하는 문서처럼, 결과를 비교할 수 있는 작업을 골라보자. 같은 입력을 기존 방식과 Jev로 각각 처리해보면 예제가 잘 작동하는지를 넘어 자신의 작업에도 도움이 되는지 확인할 수 있다.
처음 비교할 데이터는 자신이 이해할 수 있는 리뷰 20~30개 정도면 된다. 명확한 사례와 애매한 사례를 섞고, 모델의 답을 보기 전에 기대 분류를 붙인다. 일부 사례로 질문을 조정하고 남겨 둔 사례에서 다시 확인한다. 같은 기준을 기존 LLM에도 적용해 유형별 오류, 요청 시간, 사용량을 비교하면 된다. 이 표본은 초기 오류를 찾는 용도이며, 확률 보정이나 일반 성능을 입증할 규모는 아니다.
정리h2
Jev는 문맥을 읽고 항목을 고르거나 점수를 매기는 작업에 사용할 수 있는 모델이다. 요청마다 질문과 선택 기준을 정하고, 여러 질문의 결과를 확률과 함께 받는다. 리뷰 분류뿐 아니라 고객 문의 처리, 검색 문서 선별, 문서 정리에도 이런 방식을 적용할 수 있다.
실습에서는 리뷰 코멘트 하나로 문제 유형, 재현 절차의 유무, 설명의 구체성을 확인했다. 이어서 응답값을 코드의 조건문에 연결해 다음 처리 경로를 정했다. 질문과 기준을 만드는 일, 반환된 확률을 해석하는 일, 실제 행동을 연결하는 일은 개발자의 몫이다.
Jev에서 흥미로웠던 점은 AI를 활용하는 방식을 다시 생각하게 한다는 것이다. 어떤 모델에 질문할지만 고르던 데서 한 걸음 더 나아가, 작업을 어떻게 나누고 각각을 무엇에 맡길지 고민하게 된다. 생성은 LLM에, 분류와 평가는 Jev 같은 모델에, 정확한 계산과 실행 조건은 코드에 맡기는 식이다.
이런 모델이 더 다양해지고 실제 서비스에서 효과를 보여준다면, 개발자가 AI를 조합하는 방식도 달라질 것 같다. 같은 일을 처리하는 데 필요한 토큰은 앞으로 얼마나 더 줄어들 수 있을까? 생성과 분류를 넘어, 각기 다른 작업에 특화된 모델은 또 얼마나 다양하게 등장할까? 이런 변화가 실제 비용과 대기 시간을 줄여준다면 개인 개발자가 시도할 수 있는 서비스도 더 많아질 것 같다. Jev 이후에는 어떤 새로운 시도가 이어질지 기대된다.